智能客服常需要先判断问题属于订单、支付还是投诉,再交给相应流程或子 Agent。本讲比较基于 LLM 语义理解和基于向量相似度的两种分类方式。
下面分别介绍这两种分类方式。
基于 LLM 的语义理解
1.1 定义分类枚举
    enum CustomerServiceCategory {
        PRODUCT("产品相关"),
        ORDER("订单相关"),
        ACCOUNT("账户相关"),
        MEMBER("会员相关"),
        PAYMENT("支付相关"),
        OTHERS("其它问题");

        @Getter
        private final String desc;

        CustomerServiceCategory(String desc) {
            this.desc = desc;
        }
    }
1.2 定义 AIService 接口
    interface CustomerServiceCategoryClassifier {
        @UserMessage("将客人遇到的问题【{{text}}】归类")
        CustomerServiceCategory classify(String text);
    }
1.3 测试
    @GetMapping(value = "/classify", produces = MediaType.APPLICATION_JSON_VALUE)
    public ResponseEntity<String> classify(@RequestParam String query) {
        try {
            CustomerServiceCategoryClassifier customerServiceClassifier = AiServices.create(CustomerServiceCategoryClassifier.class, ollamaChatModel);
            CustomerServiceCategory classify = customerServiceClassifier.classify(query);
            return ResponseEntity.ok(classify.getDesc());
        } catch (Exception e) {
            log.error("classify", e);
            return ResponseEntity.ok("{\"error\":\"classify error: " + e.getMessage() + "\"}");
        }
    }
效果:
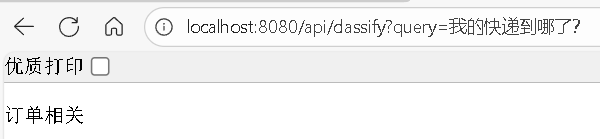
原文配图:文本分类:模型判断与向量相似度示意 3。
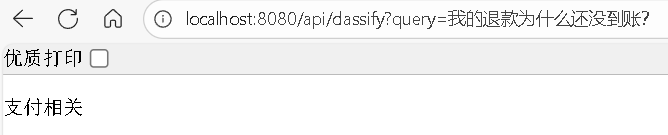
原文配图:文本分类:模型判断与向量相似度示意 5。
观察日志的话,能看到与LLM的交互:
查看原文日志(未经本站复测)
2025-12-09T21:00:57.280+08:00  INFO 5948 --- [langchain4j-study] [io-8080-exec-10] d.l.http.client.log.LoggingHttpClient    : HTTP request:
- method: POST
- url: http://localhost:11434/api/chat
- headers: [Content-Type: application/json]
- body: {
  "model" : "deepseek-v3.1:671b-cloud",
  "messages" : [ {
    "role" : "user",
    "content" : "将客人遇到的问题【我的退款为什么还没到账?】归类\nYou must answer strictly with one of these enums:\nPRODUCT\nORDER\nACCOUNT\nMEMBER\nPAYMENT\nOTHERS"
  } ],
  "options" : {
    "stop" : [ ]
  },
  "stream" : false,
  "tools" : [ ]
}
这种方法的准确性完全取决于模型能力的强弱,大多数情况下是OK的,但有些case可能会不太符合我们的预期,比如:
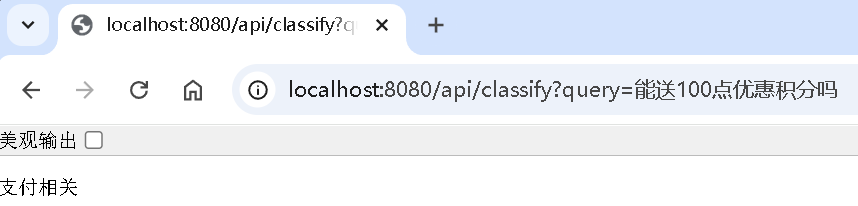
原文配图:文本分类:模型判断与向量相似度示意 1。
一些互联网平台,对于“积分”可能会归到【会员相关】(比如:积分累积到了一定程度,可以兑换成高等级会员),这时候就可以考虑第2种方法。
基于向量数据库的相似度计算
2.1 先梳理已知问题的归类
    Map<CustomerServiceCategory, List<String>> getExamples() {
        Map<CustomerServiceCategory, List<String>> examples = new HashMap<>();

        examples.put(PRODUCT, asList(
                "怎么没有产品说明书?",
                "产品的保修期过了怎么办?",
                "我新买的东西用了一周就坏了?",
                "产品无法使用?"
        ));

        examples.put(ORDER, asList(
                "我的订单现在到哪里了?",
                "能给我一个快递单号吗?",
                "我怎么知道我的订单已经发货了?",
                "我可以更改配送方式吗?",
                "你们提供次日达服务吗?",
                "可以选择到店自提吗?",
                "我的订单什么时候能到?",
                "为什么我的配送延迟了?",
                "我可以指定配送日期吗?",
                "已经过了预计送达日期,我的订单在哪里?",
                "如果出现延迟,我会收到通知吗?",
                "天气原因会导致配送延迟多久?",
                "我收到了订单,但少了一件商品。",
                "包裹送达时是空的。",
                "我收到的商品错了,该怎么办?",
                "我所有的商品会同时送达吗?",
                "为什么我只收到部分订单商品?",
                "剩下的商品能更快送达吗?"
        ));

        examples.put(PAYMENT, asList(
                "能用支付宝吗?",
                "微信支付可以吗?",
                "支持信用卡吗?",
                "付款时我遇到一个错误",
                "可以通过银行转账付款吗?",
                "为什么我的付款被拒绝了",
                "可以给我发送上一笔订单的发票吗?",
                "发票会自动发送到我的电子邮箱吗?",
                "如何申请退款?"
        ));

        examples.put(MEMBER, asList(
                "我的会员等级变低了?",
                "我的积分过期了?",
                "我的优惠券不能用了?",
                "能给我发个支付95折优惠券吗?",
                "满减优惠券当次消费就能用吗?",
                "能送100点优惠积分吗?"
        ));

        examples.put(ACCOUNT, asList(
                "如何注销账号?",
                "我的密码过期了?",
                "为什么无法登录",
                "登录时手机收不到验证码",
                "如果更换账号绑定的手机号"
        ));

        examples.put(OTHERS, asList(
                "厂商的联系电话是多少?",
                "如何加盟?",
                "你们公司还招人吗?"
        ));

        return examples;
    }
2.2 使用embedding模型分类
    @GetMapping(value = "/classify/embed", produces = MediaType.APPLICATION_JSON_VALUE)
    public ResponseEntity<String> classifyEmbed(@RequestParam String query) {
        try {
            TextClassifier<CustomerServiceCategory> classifier = new EmbeddingModelTextClassifier<>(ollamaEmbeddingModel, getExamples());
            List<CustomerServiceCategory> categories = classifier.classify(query);
            String result = "";
            if (!CollectionUtils.isEmpty(categories)) {
                CustomerServiceCategory classify = categories.get(0);
                result += classify.getDesc() + ",";
            }
            return ResponseEntity.ok(StringUtils.trimTrailingCharacter(result, ','));
        } catch (Exception e) {
            log.error("classify", e);
            return ResponseEntity.ok("{\"error\":\"classify error: " + e.getMessage() + "\"}");
        }
    }
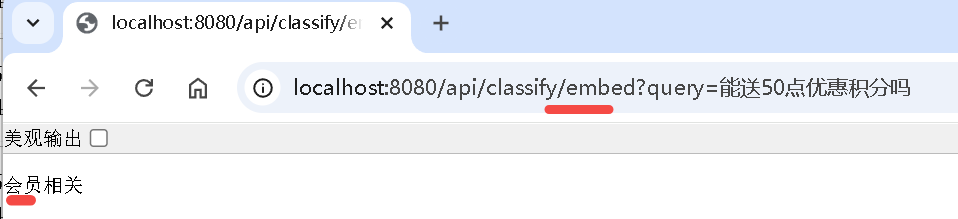
原文配图:文本分类:模型判断与向量相似度示意 4。
刚才的case符合预期了,但该方法有缺陷也十分明显,如果梳理的已知问题分类不够全面,会出现误判,比如:
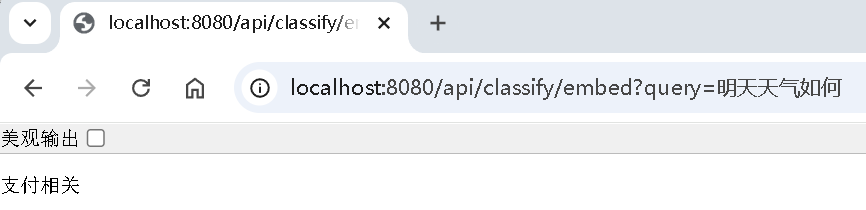
原文配图:文本分类:模型判断与向量相似度示意 2。
这个问题不在预先准备的问题列表中,示例的分类结果并不理想。两种方式如何取舍,需要结合业务场景。也可以把它们结合起来:同时分类并检查结果是否一致,再按策略处理;或者先用模型完成一轮分类,经人工复核后补充向量分类所用的示例列表。